【版权声明】版权所有,请勿转载!
作者:厦门大学计算机系林子雨副教授
E-mail: ziyulin@xmu.edu.cn
相关链接:大数据软件安装和基础编程实践指南(2026年10月版)
本博客内容与林子雨编著《大数据技术原理与应用(第5版)》(访问教材官网)教材配套。
本指南介绍了数据智能体的构建方法,采用Ubuntu24.04系统、Ollama本地大模型、MySQL数据库、TraeCode和Python编程语言。
一、准备工作
1.安装Ollama本地大模型
构建数据智能体需要使用Ollama本地大模型服务,请参考“在Ubuntu中安装Ollama大模型”教程在本地计算机上安装Ollama。
2. 安装MySQL数据库
本案例采用MySQL数据库存储数据,因此,需要首先安装MySQL数据库。请参考“Ubuntu安装MySQL”教程完成MySQL数据库的安装。
3.安装IDE工具TraeCode
本案例开发工具采用字节跳动公司的TraeCode,请参考“在Ubuntu中安装TraeCode”教程完成TraeCode的安装。
4.安装Python
本案例通过Anaconda3来实现Python的安装,请参考“在Ubuntu系统中安装Anaconda3”教程完成Anaconda3的安装(如果已经安装过,就不要重复安装)。
二、智能体构建实践
1.打开TraeCode
在Ubuntu中使用快捷键“Ctrl+Alt+T”新建一个终端,在终端中执行如下命令启动TraeCode:
trae-cn启动后会出现如下界面:
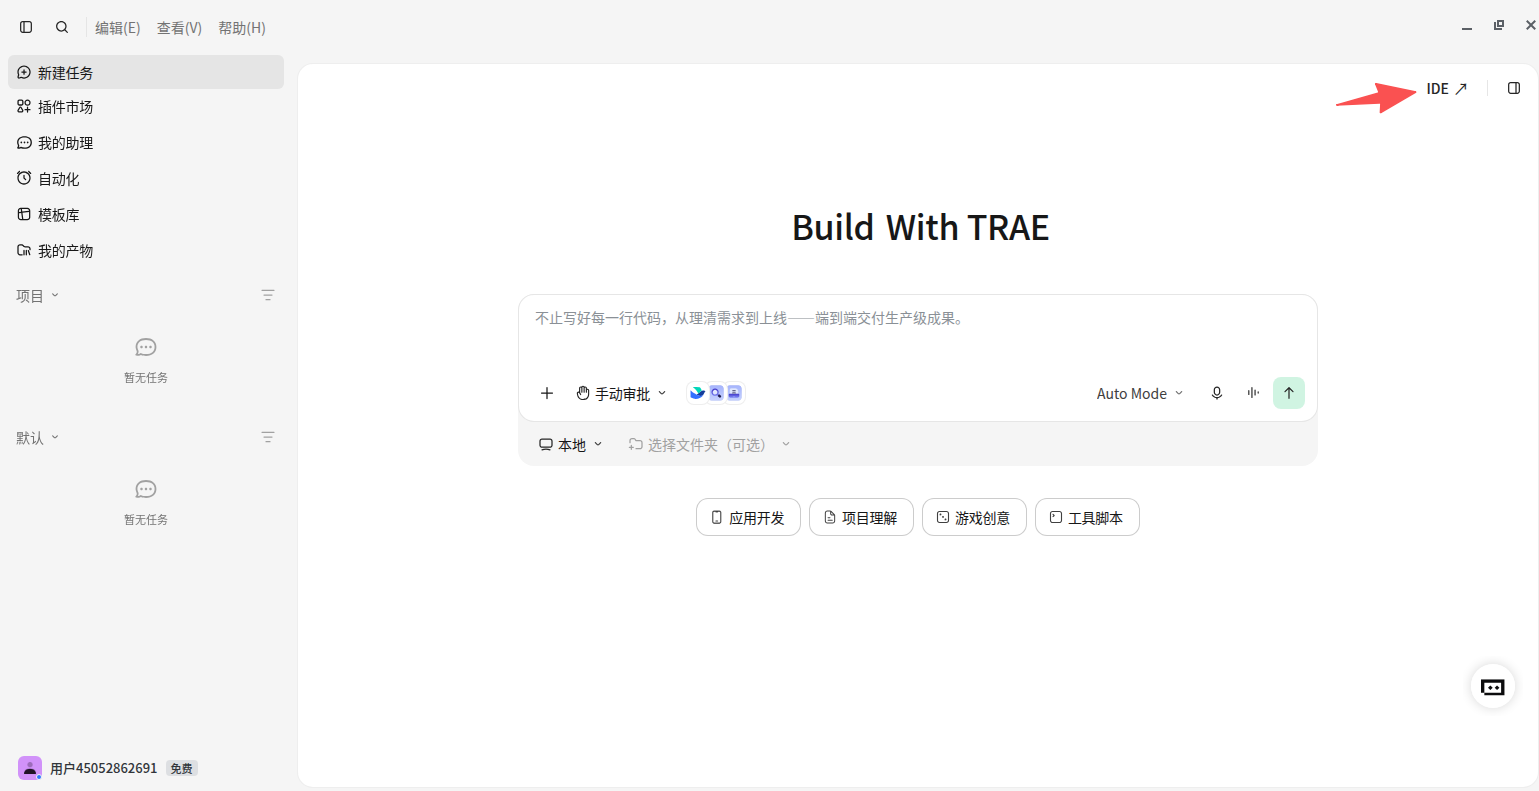
点击界面右上角的IDE图标,把TraeCode切换到IDE模式。
切换到IDE模式以后的界面如下:
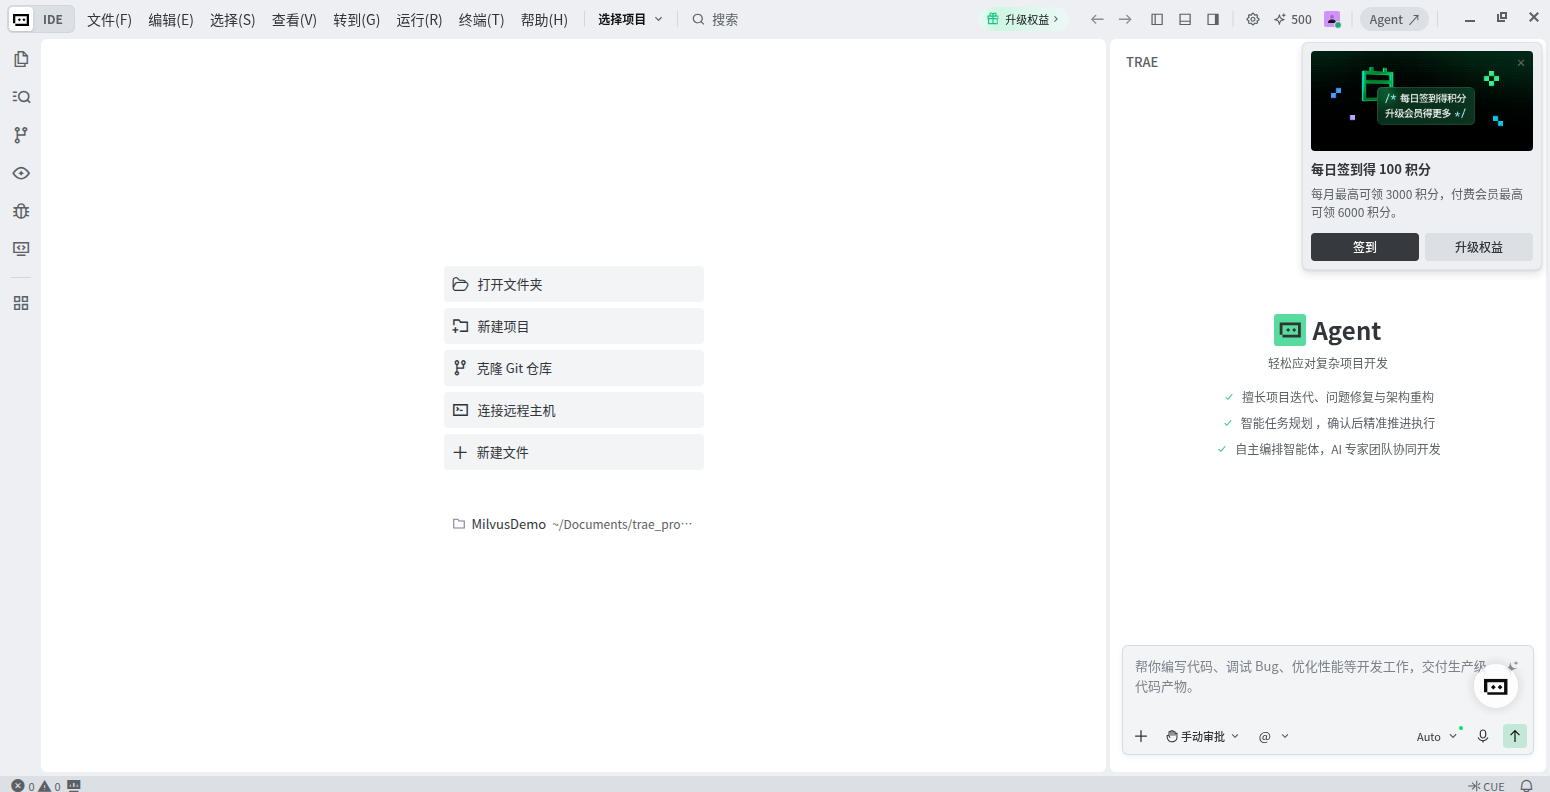
2.为TraeCode安装Python插件
如果此前已经安装了Python插件,这里不要重复安装。
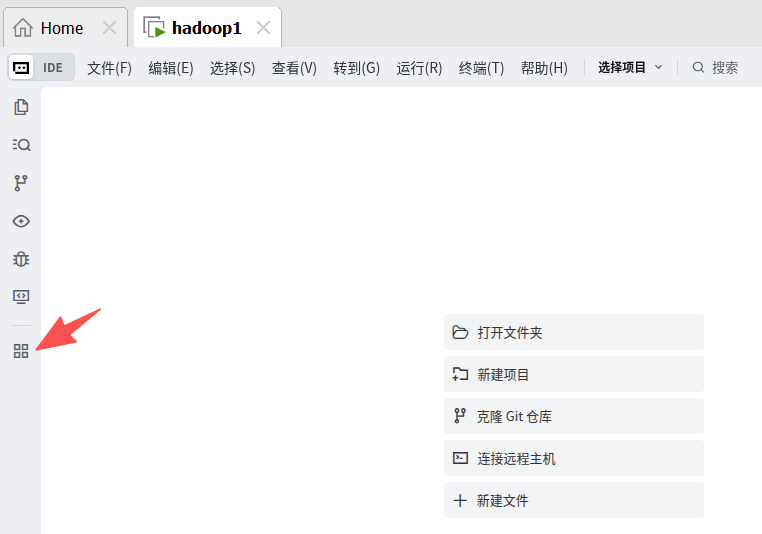
如果要调试Python代码,则需要为TraeCode安装Python插件。如下图所示,点击“扩展”按钮。
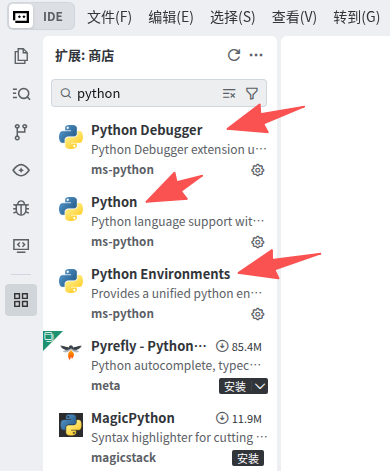
在弹出的界面中(如下图所示),在搜索框中输入“Python”,把搜索到的3个Python插件安装到本地。
3.新建项目
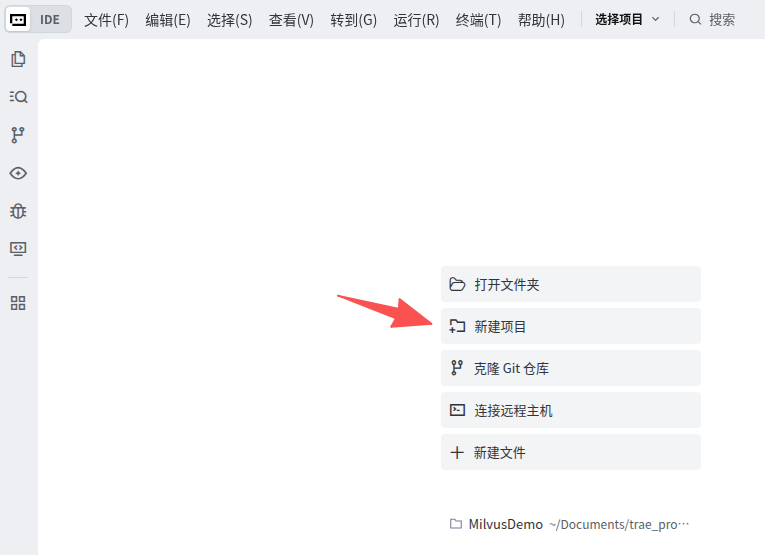
如下图所示,在界面中点击“新建项目”。
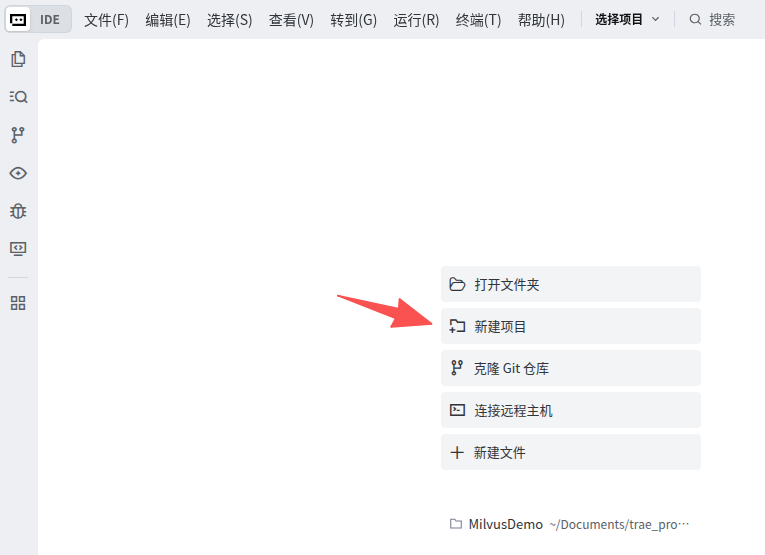
在弹出的项目对话框中(如下图所示),输入你的项目名称“DataAgentDemo”,点击“确认”即可。
4. 构建Python虚拟环境和安装Python依赖包
这里为DataAgentDemo项目构建一个Python虚拟环境,方便管理Python依赖包。
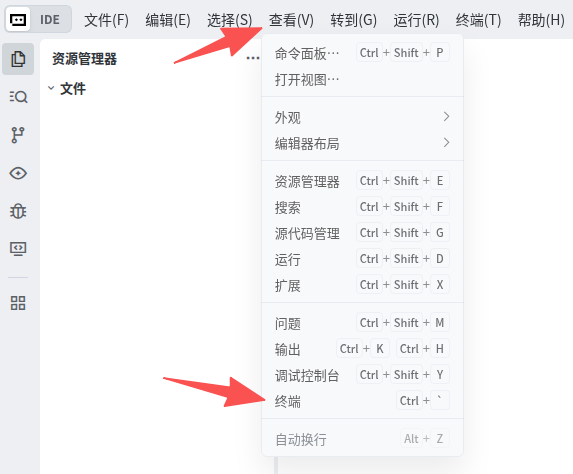
在TraeCode界面中(如下图所示),在顶部菜单中点击“查看”,在弹出的菜单中点击“终端”,打开终端窗口。
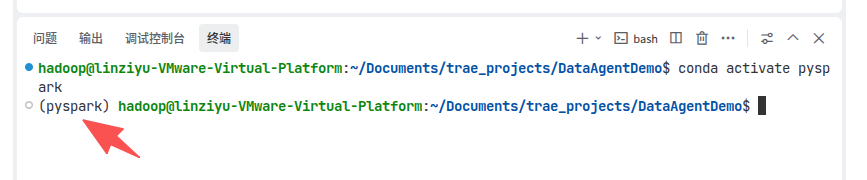
这里我们要使用Python 3.11版本,前面在安装Anaconda3教程中,已经创建了一个名称为pyspark的python3.11环境,这里可以在终端中执行如下命令激活pyspark环境:
conda activate pyspark该命令执行以后,如下图所示,在命令提示符前面会出现“pyspark”前缀,就表示已经激活pyspark环境,里面的Python版本就是3.11。
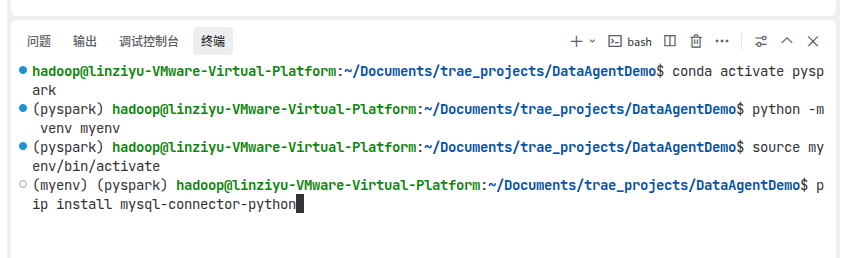
下面为本案例构建一个Python虚拟环境myenv,执行如下命令:
python -m venv myenv然后,使用如下命令激活虚拟环境myenv:
source myenv/bin/activate激活myenv环境以后,可以看到,在命令提示符前面又多了一个前缀“myenv”。Python程序连接MySQL数据库,需要使用mysql-connector-python依赖包。可以继续执行如下命令在myenv环境中安装依赖包:
pip install mysql-connector-python执行上述命令的效果截图如下图所示:
5. 编写智能体程序
在TraeCode界面的左侧,点击“新建文件”的图标,如下图所示:
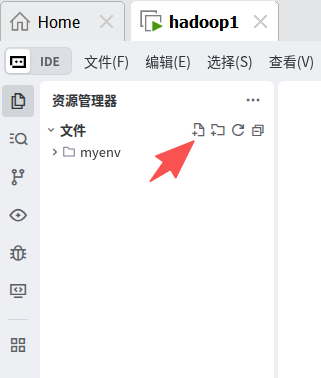
输入文件名simple_mysql_data_agent.py,把下面代码粘贴到该文件中,然后保存代码文件:
# simple_mysql_data_agent.py
from __future__ import annotations

import json
import re
from urllib import request

import mysql.connector

MYSQL_CONFIG = {
    "host": "127.0.0.1",
    "port": 3306,
    "user": "root",
    "password": "123456",
}
DATABASE_NAME = "student_scores_demo"
OLLAMA_URL = "http://localhost:11434/api/generate"
MODEL = "gemma4:e4b"

USER_QUESTION = "2026秋季大数据技术原理与应用课程的平均分是多少?"

def get_connection(use_database: bool = True):
    """连接 MySQL。首次建库时不指定 database。"""
    config = MYSQL_CONFIG.copy()
    if use_database:
        config["database"] = DATABASE_NAME
    return mysql.connector.connect(**config)

def create_demo_database() -> None:
    """创建 MySQL 测试数据库,并写入学生、课程和成绩数据。"""
    conn = get_connection(use_database=False)
    cur = conn.cursor()
    cur.execute(f"CREATE DATABASE IF NOT EXISTS {DATABASE_NAME} DEFAULT CHARACTER SET utf8mb4")
    cur.close()
    conn.close()

    conn = get_connection(use_database=True)
    cur = conn.cursor()

    cur.execute("DROP TABLE IF EXISTS score")
    cur.execute("DROP TABLE IF EXISTS course")
    cur.execute("DROP TABLE IF EXISTS student")

    cur.execute("""
    CREATE TABLE student (
        student_id INTEGER PRIMARY KEY,
        name VARCHAR(50) NOT NULL,
        class_name VARCHAR(50) NOT NULL
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4
    """)
    cur.execute("""
    CREATE TABLE course (
        course_id INTEGER PRIMARY KEY,
        course_name VARCHAR(100) NOT NULL,
        term VARCHAR(30) NOT NULL
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4
    """)
    cur.execute("""
    CREATE TABLE score (
        student_id INTEGER NOT NULL,
        course_id INTEGER NOT NULL,
        score_value DECIMAL(5, 2) NOT NULL,
        FOREIGN KEY(student_id) REFERENCES student(student_id),
        FOREIGN KEY(course_id) REFERENCES course(course_id)
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4
    """)

    students = [
        (1, "张华", "大数据1班"),
        (2, "李明", "大数据1班"),
        (3, "王芳", "大数据2班"),
        (4, "赵强", "大数据2班"),
    ]
    courses = [
        (101, "大数据技术原理与应用", "2026秋季"),
        (102, "AI编程与智能体开发", "2026秋季"),
    ]
    scores = [
        (1, 101, 88), (2, 101, 76), (3, 101, 92), (4, 101, 81),
        (1, 102, 95), (2, 102, 84), (3, 102, 89), (4, 102, 78),
    ]

    cur.executemany("INSERT INTO student VALUES (%s, %s, %s)", students)
    cur.executemany("INSERT INTO course VALUES (%s, %s, %s)", courses)
    cur.executemany("INSERT INTO score VALUES (%s, %s, %s)", scores)
    conn.commit()
    cur.close()
    conn.close()

def ask_ollama_for_sql(question: str) -> str:
    """调用 Ollama,把自然语言问题转换成 SQL。"""
    schema = """
    数据库是 MySQL,包含三张表:
    student(student_id, name, class_name)
    course(course_id, course_name, term)
    score(student_id, course_id, score_value)
    表之间的连接关系:
    score.student_id = student.student_id
    score.course_id = course.course_id
    """
    prompt = f"""
你是一个只会生成 MySQL 查询语句的助手。
请根据用户问题生成一条 SELECT 语句,不要解释,不要使用 Markdown。
只能查询上面给出的三张表,不能生成 INSERT、UPDATE、DELETE、DROP、ALTER 等语句。

{schema}

用户问题:{question}
SQL:
"""
    payload = json.dumps({
        "model": MODEL,
        "prompt": prompt,
        "stream": False,
        "options": {"temperature": 0}
    }).encode("utf-8")
    req = request.Request(
        OLLAMA_URL,
        data=payload,
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    with request.urlopen(req, timeout=300) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    return cleanup_sql(data["response"])

def cleanup_sql(text: str) -> str:
    """去掉模型可能附带的代码块标记,只保留 SQL。"""
    text = text.strip()
    text = re.sub(r"^```sql\s*", "", text, flags=re.IGNORECASE)
    text = re.sub(r"^```\s*", "", text)
    text = re.sub(r"\s*```$", "", text)
    return text.strip().rstrip(";")

def validate_readonly_sql(sql: str) -> None:
    """最小安全检查:本案例只允许执行 SELECT 查询。"""
    lowered = sql.lower()
    forbidden = ["insert", "update", "delete", "drop", "alter", "create", "pragma"]
    if not lowered.startswith("select"):
        raise ValueError("只允许执行 SELECT 查询。")
    if any(word in lowered for word in forbidden):
        raise ValueError("SQL 中包含不允许的操作。")

def run_query(sql: str) -> tuple[list[str], list[tuple]]:
    validate_readonly_sql(sql)
    conn = get_connection(use_database=True)
    cur = conn.cursor()
    cur.execute(sql)
    columns = [item[0] for item in cur.description]
    rows = cur.fetchall()
    cur.close()
    conn.close()
    return columns, rows

def print_result(question: str, sql: str, columns: list[str], rows: list[tuple]) -> None:
    print("用户问题:", question)
    print("生成SQL:", sql)
    print("查询结果:")
    print(" | ".join(columns))
    for row in rows:
        print(" | ".join(str(value) for value in row))

if __name__ == "__main__":
    create_demo_database()
    sql = ask_ollama_for_sql(USER_QUESTION)
    columns, rows = run_query(sql)
    print_result(USER_QUESTION, sql, columns, rows)
6.启动MySQL数据库服务
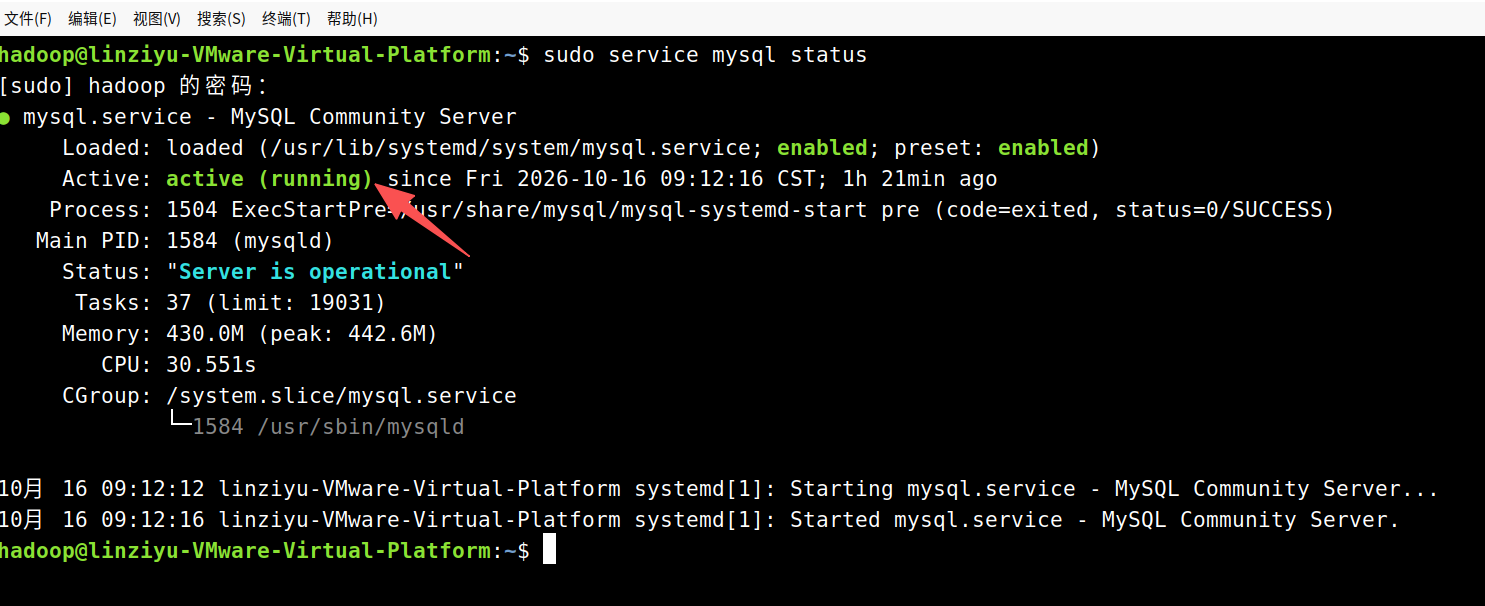
如果按照前面教程完成了MySQL数据库的安装,一般默认MySQL数据库是启动的。可以在Ubuntu中新建一个终端(不是在TraeCode中的终端),在终端中执行如下命令检查MySQL是否启动成功:
sudo service mysql status如果该命令执行以后可以看到“active(running)”的文字,就说明MySQL已经启动成功,如下图所示:
如果发现MySQL没有处于启动状态,则可以在Ubuntu的终端中执行如下命令启动MySQL服务:
sudo systemctl start mysql7.启动Ollama本地服务
在前面安装Ollama的教程中,已经安装了Ollama,并且下载了Gemma4大模型,在Ubuntu终端中执行如下命令启动Ollama本地服务:
cd /usr/local/ollama
./bin/ollama serve # 启动Ollama本地服务
8.执行程序
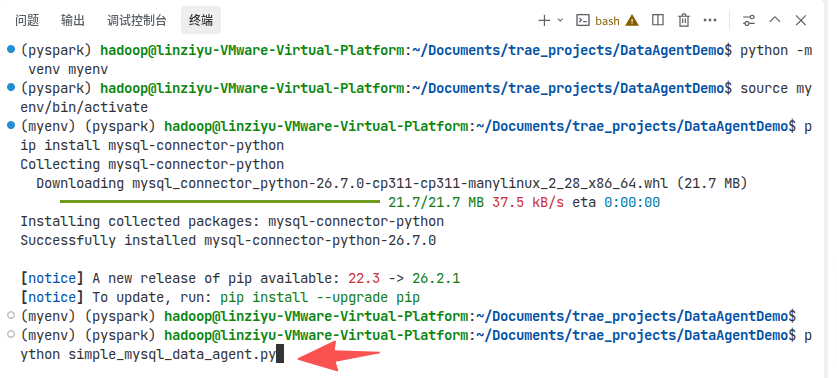
在TraeCode的终端窗口里面(不是Ubuntu的终端窗口),执行如下命令运行程序simple_mysql_data_agent.py:
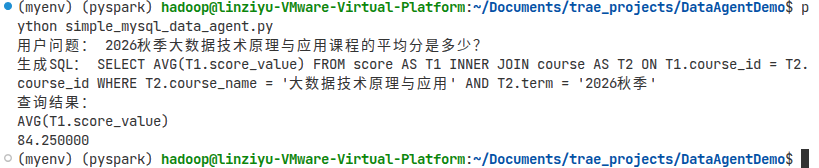
python simple_mysql_data_agent.py如下图所示:
程序执行结果如下图所示: