作者:厦门大学计算机系 林子雨 副教授
Ollama是一个开源的本地大语言模型(LLM)运行工具,支持 Windows、macOS、Linux等平台。它让你无需联网和复杂配置,一键下载、运行并管理各类开源模型,如Llama、Qwen、Gemma等。通过简单的命令行即可拉取模型、启动服务,还提供Python等API接口,方便开发者集成到应用中,是本地部署AI应用的热门选择。
1.下载Ollama安装文件
可以到《大数据技术原理与应用(第5版)》教材官网的“下载专区”的“软件”目录下去下载ollama-linux-amd64.tar.zst。或者也可以直接点击这里从百度云盘下载软件(提取码:ziyu)。进入百度网盘后,进入“软件”目录,找到ollama-linux-amd64.tar.zst文件,下载到本地,假设保存到“~/Downloads”目录下。
2.解压安装文件
cd /usr/local
mkdir ollama
sudo chown -R hadoop ./ollama
# 需要zstd工具
sudo apt-get install zstd
cd ~/Downloads
# 一步完成:zstd 解压 + tar 拆包到 /usr
sudo tar -I zstd -C /usr/local/ollama -xf ollama-linux-amd64.tar.zst
完成解压。
3.启动Ollama服务
下面在Ubuntu的终端中执行如下命令启动Ollama本地服务:
cd /usr/local/ollama
./bin/ollama serve # 启动Ollama本地服务
启动以后,不要关闭这个终端,否则会停止服务。
4.下载Gemma4大模型
然后,另外新建一个终端,执行如下命令下载Gemma4:e4b模型到本地:
cd /usr/local/ollama
./bin/ollama pull gemma4:e4b # 下载大模型到本地
该命令执行以后,会显示下载进度条,如下图所示:
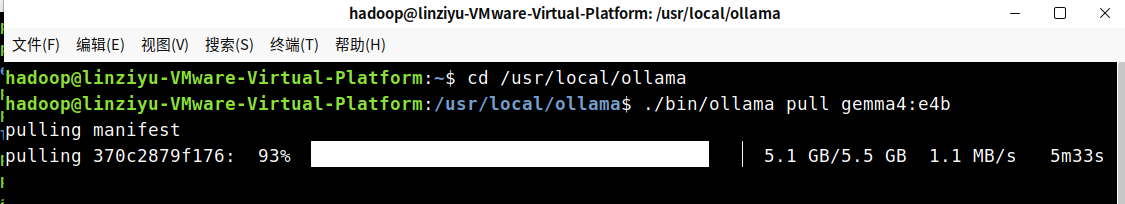
上面这个下载过程比较耗时,可能需要花费十几分钟。
下载完成以后,可以执行如下命令查看已经下载到本地的大模型列表:
cd /usr/local/ollama
./bin/ollama list        # 查看本机已拉取的模型
5.启动Gemma4大模型
可以执行如下命令启动Gemm4大模型服务:
cd /usr/local/ollama
./bin/ollama run gemma4:e4b
Gemma4大模型启动以后的效果如下图所示:
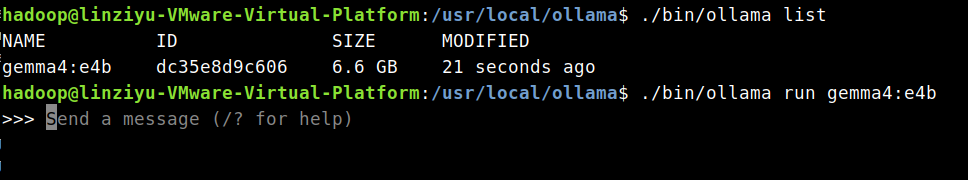
然后,就可以在>>>后面输入你的问题,向大模型发起提问。需要说明的是,“ollama run gemma4:e4b”命令是启动用户对话客户端,让用户可以输入问题与大模型对话。如果你是使用Python程序访问Gemm4大模型,则不需要运行“ollama run gemma4:e4b”命令,只要运行命令“ollama serve”启动Olmma服务即可。