【版权声明】版权所有,请勿转载!
作者:厦门大学计算机系林子雨副教授
E-mail: ziyulin@xmu.edu.cn
本博客内容与林子雨编著《大数据技术原理与应用(第5版)》(访问教材官网)教材配套。
本指南介绍了Hadoop3.5.0的安装和使用方法。
下载Hadoop3.5.0安装文件
Hadoop3.5.0安装文件hadoop-3.5.0.tar.gz,可以到《大数据技术原理与应用(第5版)》教材官网的“下载专区”的“软件”目录下去下载hadoop-3.5.0.tar.gz。或者也可以直接点击这里从百度云盘下载软件(提取码:ziyu)。进入百度网盘后,进入“软件”目录,找到hadoop-3.5.0.tar.gz文件,下载到本地。
环境
本教程使用 Ubuntu 24.04 64位 作为系统环境,请自行安装Ubuntu系统(可参考:在VMWare中安装Linux虚拟机)。
装好了 Ubuntu 系统之后,在安装 Hadoop 前还需要做一些必备工作。
创建hadoop用户
如果你安装 Ubuntu 的时候不是用的 "hadoop" 用户,那么需要增加一个名为 hadoop 的用户。
首先按 ctrl+alt+t 打开终端窗口,输入如下命令创建新用户 :
sudo useradd -m hadoop -s /bin/bash这条命令创建了可以登陆的 hadoop 用户,并使用 /bin/bash 作为 shell。
接着使用如下命令设置密码,可简单设置为 hadoop,按提示输入两次密码:
sudo passwd hadoop可为 hadoop 用户增加管理员权限,方便部署,避免一些对新手来说比较棘手的权限问题:
sudo adduser hadoop sudo更新apt
用 hadoop 用户登录后,我们先更新一下 apt,后续我们使用 apt 安装软件,如果没更新可能有一些软件安装不了。按 ctrl+alt+t 打开终端窗口,执行如下命令:
sudo apt-get update后续需要更改一些配置文件,这里推荐使用Vim编辑器(vi编辑器增强版,基本用法相同),可以执行如下命令安装Vim编辑器:
sudo apt-get install vim安装软件时若需要确认,在提示处输入 y 即可。
如果你不会使用Vim编辑器,可以点击这里查看Vim编辑器使用方法。
最后注销当前用户,返回登录界面。在登录界面中选择刚创建的 hadoop 用户进行登录,进入Ubuntu24.04系统。
安装SSH、配置SSH无密码登陆
集群、单节点模式都需要用到 SSH 登录(类似于远程登录,你可以登录某台 Linux 主机,并且在上面运行命令),Ubuntu 默认已安装了 SSH client,此外还需要安装 SSH server:
sudo apt-get install openssh-server安装后,可以使用如下命令登录本机:
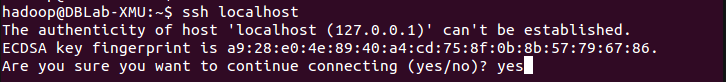
ssh localhost此时会有如下提示(SSH首次登陆提示),输入 yes 。然后按提示输入密码 hadoop,这样就登录到本机了。
但这样登录是需要每次输入密码的,我们需要配置成SSH无密码登录比较方便。
首先退出刚才的 ssh,就回到了我们原先的终端窗口,然后利用 ssh-keygen 生成密钥,并将密钥加入到授权中:
exit                           # 退出刚才的 ssh localhost
cd ~/.ssh/                     # 若没有该目录,请先执行一次ssh localhost
ssh-keygen -t rsa              # 会有提示,都按回车就可以
cat ./id_rsa.pub >> ./authorized_keys  # 加入授权
安装Java环境
这里推荐采用手动安装方式安装Java环境。
Hadoop3.5.0需要JDK版本在17及以上。需要按照下面步骤来自己手动安装JDK17。
我们已经把JDK1.8的安装包OpenJDK17U-jdk_x64_linux_hotspot_17.0.20.1_1.tar.gz放在了第5版教材的教材官网的“下载专区”的“软件”目录下,。请把压缩格式的文件OpenJDK17U-jdk_x64_linux_hotspot_17.0.20.1_1.tar.gz下载到本地电脑,假设保存在“/home/hadoop/Downloads/”目录下。
在Linux命令行界面中,执行如下Shell命令(注意:当前登录用户名是hadoop):
cd /usr/lib
sudo mkdir jvm #创建/usr/lib/jvm目录用来存放JDK文件
cd ~ #进入hadoop用户的主目录
cd Downloads  #注意区分大小写字母,刚才已经通过FTP软件把JDK安装包OpenJDK17U-jdk_x64_linux_hotspot_17.0.20.1_1.tar.gz上传到该目录下
sudo tar -zxvf ./OpenJDK17U-jdk_x64_linux_hotspot_17.0.20.1_1.tar.gz -C /usr/lib/jvm #把JDK文件解压到/usr/lib/jvm目录下上面使用了解压缩命令tar,如果对Linux命令不熟悉,可以参考常用的Linux命令用法。
JDK文件解压缩以后,可以执行如下命令到/usr/lib/jvm目录查看一下:
cd /usr/lib/jvm
ls
可以看到,在/usr/lib/jvm目录下有个jdk1.8.0_371目录。
下面继续执行如下命令,设置环境变量:
cd ~
vim ~/.bashrc上面命令使用vim编辑器(查看vim编辑器使用方法)打开了hadoop这个用户的环境变量配置文件,请在这个文件的开头位置,添加如下几行内容:
export JAVA_HOME=/usr/lib/jvm/jdk-17.0.20.1+1
export JRE_HOME=${JAVA_HOME}/jre
export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib
export PATH=${JAVA_HOME}/bin:$PATH
保存.bashrc文件并退出vim编辑器。然后,继续执行如下命令让.bashrc文件的配置立即生效:
source ~/.bashrc这时,可以使用如下命令查看是否安装成功:
java -version如果能够在屏幕上返回如下信息,则说明安装成功:
hadoop@ubuntu:~$ java -version
openjdk version "17.0.20.1" 2026-08-18
OpenJDK Runtime Environment Temurin-17.0.20.1+1 (build 17.0.20.1+1)
OpenJDK 64-Bit Server VM Temurin-17.0.20.1+1 (build 17.0.20.1+1, mixed mode
安装 Hadoop3.5.0
Hadoop安装文件,可以到Hadoop官网或者第5版教材官网的“下载专区”的“软件”目录中下载hadoop-3.5.0.tar.gz(下载地址可以见本网页开头)。
这里选择将Hadoop安装至 /usr/local/ 中:
sudo tar -zxvf ~/Downloads/hadoop-3.5.0.tar.gz -C /usr/local    # 解压到/usr/local中
cd /usr/local/
sudo mv ./hadoop-3.5.0/ ./hadoop # 将文件夹名改为hadoop
sudo chown -R hadoop:hadoop ./hadoop # 修改文件权限
Hadoop 解压后即可使用。输入如下命令来检查 Hadoop 是否可用,成功则会显示 Hadoop 版本信息:
cd /usr/local/hadoop
./bin/hadoop version
上面命令执行以后,如果成功,会返回如下信息:
Hadoop 3.5.0
Source code repository https://github.com/apache/hadoop.git -r dbcc7cd797100e6b32cd84f85b53a5193a5f9af0
Compiled by cnauroth on 2026-03-24T16:56Z
Compiled on platform linux-x86_64
Compiled with protoc 3.25.5
From source with checksum 64582ed0a62a169c39a19c734a8f33b5
This command was run using /usr/local/hadoop/share/hadoop/common/hadoop-common-3.5.0.jar
Hadoop伪分布式配置(在单个节点中运行Hadoop)
Hadoop 可以在单个节点上以伪分布式的方式运行,Hadoop 进程以分离的 Java 进程来运行,节点既作为 NameNode 也作为 DataNode,同时,读取的是 HDFS 中的文件。
Hadoop 的配置文件位于 /usr/local/hadoop/etc/hadoop/ 中,伪分布式需要修改2个配置文件 core-site.xml 和 hdfs-site.xml 。Hadoop的配置文件是 xml 格式,每个配置以声明 property 的 name 和 value 的方式来实现。
使用Vim编辑器修改配置文件 core-site.xml ,将当中的
<configuration>
</configuration>
修改为下面配置:
<configuration>
    <property>
        <name>hadoop.tmp.dir</name>
        <value>file:/usr/local/hadoop/tmp</value>
        <description>Abase for other temporary directories.</description>
    </property>
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://localhost:9000</value>
    </property>
</configuration>
同样地,修改配置文件 hdfs-site.xml,修改为如下内容:
<configuration>
    <property>
        <name>dfs.replication</name>
        <value>1</value>
    </property>
    <property>
        <name>dfs.namenode.name.dir</name>
        <value>file:/usr/local/hadoop/tmp/dfs/name</value>
    </property>
    <property>
        <name>dfs.datanode.data.dir</name>
        <value>file:/usr/local/hadoop/tmp/dfs/data</value>
    </property>
</configuration>
伪分布式虽然只需要配置 fs.defaultFS 和 dfs.replication 就可以运行(官方教程如此),不过若没有配置 hadoop.tmp.dir 参数,则默认使用的临时目录为 /tmp/hadoo-hadoop,而这个目录在重启时有可能被系统清理掉,导致必须重新执行 format 才行。所以我们进行了设置,同时也指定 dfs.namenode.name.dir 和 dfs.datanode.data.dir,否则在接下来的步骤中可能会出错。
配置完成后,执行 NameNode 的格式化:
cd /usr/local/hadoop
./bin/hdfs namenode -format
成功的话,会看到 "successfully formatted" 的提示,具体返回信息类似如下:
hadoop@ubuntu-kylin:/usr/local/hadoop$ ./bin/hdfs namenode -format
WARNING: /usr/local/hadoop/logs does not exist. Creating.
2026-09-29 06:36:17,363 INFO namenode.NameNode: STARTUP_MSG:
/************************************************************
STARTUP_MSG: Starting NameNode
STARTUP_MSG:   host = ubuntu-kylin/127.0.1.1
STARTUP_MSG:   args = [-format]
STARTUP_MSG:   version = 3.5.0
......
2026-09-29 06:36:20,397 INFO namenode.FSImage: Allocated new BlockPoolId: BP-477296363-127.0.1.1-1790663780339
2026-09-29 06:36:20,460 INFO common.Storage: Storage directory /usr/local/hadoop/tmp/dfs/name has been successfully formatted.
2026-09-29 06:36:21,209 INFO namenode.NameNode: SHUTDOWN_MSG:
/************************************************************
SHUTDOWN_MSG: Shutting down NameNode at ubuntu-kylin/127.0.1.1
************************************************************/
接着开启 NameNode 和 DataNode 守护进程。
cd /usr/local/hadoop
./sbin/start-dfs.sh  #start-dfs.sh是个完整的可执行文件,中间没有空格
启动之后,可以执行jps命令查看所有的Java进程。如果HDFS启动成功,可以得到以下类似结果:
$jps
94082 DataNode
94583 Jps
94267 SecondaryNameNode
93994 NameNode
若要关闭 Hadoop,则运行:
./sbin/stop-dfs.sh