【版权声明】版权所有,请勿转载!
作者:厦门大学计算机系林子雨副教授
E-mail: ziyulin@xmu.edu.cn
本博客内容与林子雨编著《大数据技术原理与应用(第5版)》(访问教材官网)教材配套。
本指南介绍了向量数据库Milvus的安装和使用方法。
安装Python
在学习《大数据技术原理与应用(第5版)》的第8章向量数据库Milvs的编程实践内容时,使用了Python编程语言,因此,需要安装Python,这里通过安装Anaconda3来实现Python的安装,具体安装方法可以参考教程《在Ubuntu中安装Anaconda3》
Milvus的安装
1.Milvus Lite模式
对于初学者而言,如果只是出于简单的学习的目的,可以采用Milvus Lite嵌入式模式安装Milvus,安装命令如下:
cd /home/hadoop
conda activate pyspark
pip install -U pymilvus milvus-lite
采用上面命令安装,就同时安装了Milvus数据库客户端和嵌入式数据库引擎,不需要服务器,不需要部署,开箱即用,数据库存在本地文件,进程内运行,不需要启动服务。
然后创建一个指向本地数据库文件的MilvusClient对象,下面给出最简单的连接示例。在/home/hadoop目录下新建一个Python代码文件milvus_client_test.py:
# milvus_client_test.py
from pymilvus import MilvusClient
client=MilvusClient("milvus_demo.db")
print(client.list_collections())  # 不报错就是成功
上面的代码,直接在本地创建打开一个文件型数据库,就像SQLite和Access一样,数据存在 milvus_demo.db文件里,而不是存储在Milvus服务器里,因此,就不用安装Milvus数据库服务器,也就不用启动服务器。
可以在终端中执行如下命令运行milvus_client_test.py:
python milvus_client_test.py如果不报错,就表示Milvus Lite模式安装成功。
2.Miluvs Standalone模式
这里采用Docker方式部署Milvus Standalone。下面是Milvus Standalone模式的详细安装过程。
$ sudo apt update # 更新软件源
$ sudo apt install docker.io -y # 安装docker.io
$ sudo systemctl start docker # 启动Docker
$ docker --version # 检查是否安装成功
$ sudo usermod -aG docker $USER # 把hadoop用户加入docker组
关闭当前终端窗口,重新启动Ubuntu虚拟机,这条配置才会生效。
进入Ubuntu以后,再次执行如下命令启动Docker:
sudo systemctl start docker
docker info  # 重新登录后验证
docker pull milvusdb/milvus:latest # 下载Milvus镜像
从教材官网的“下载专区”的“代码”目录下的“第8章 向量数据库Milvus”目录下下载standalone_embed.sh文件,放置到Ubuntu系统的“/home/hadoop”目录下,然后执行如下命令:
cd /home/hadoop
chmod +x standalone_embed.sh
bash standalone_embed.sh start
需要注意的是,如果以后需要正常启动/停止Milvus服务,可以使用如下命令:
bash standalone_embed.sh stop  # 停止Milvus服务
bash standalone_embed.sh start  # 启动Milvus服务
这里假设Ubuntu系统中已经安装了Anaconda3,并且创建了Python 3.11版本的Python虚拟环境pyspark(具体方法可以参见教材官网的“实验指南”)。执行下面命令激活pyspark虚拟环境:
cd /home/hadoop
conda activate pyspark
执行如下命令为Python安装pymilvus依赖包:
pip install pymilvus==3.0.2执行下面命令使用Vim编辑器创建一个Python代码文件milvus_client_server_test.py:
vim milvus_client_server_test.py在milvus_client_server_test.py代码文件中输入如下代码:
# milvus_client_server_test.py
from pymilvus import MilvusClient
client = MilvusClient(uri="http://localhost:19530")
print(client.list_collections())
然后执行如下命令:
python milvus_client_server_test.py执行该命令以后,不报错就是成功。
Milvus Lite嵌入式向量数据库完整演示
下面通过一个完整实例,介绍如何利用Milvus Lite创建课程资源检索库。为了便于在课程实验中直接运行,本实例不依赖外部嵌入模型,而是直接构造少量4维向量来模拟文本嵌入结果。在实际应用中,只需要把这些模拟向量替换为真实嵌入模型生成的向量即可。
本实例中,首先创建一个名为course_materials的Collection,其中,包含主键字段id、向量字段embedding,以及title、category、year等标量字段;随后,向其中插入数据,分别完成向量检索、带过滤条件的检索、标量查询和删除操作。具体代码如下:
# milvus_course_demo.py
from pymilvus import MilvusClient, DataType
COLLECTION_NAME = "course_materials"
def init_client():
    return MilvusClient("course_demo.db")
def recreate_collection(client):
    if client.has_collection(collection_name=COLLECTION_NAME):
        client.drop_collection(collection_name=COLLECTION_NAME)
    schema = MilvusClient.create_schema(
        auto_id=False,
        enable_dynamic_field=True,
    )
    schema.add_field(field_name="id", datatype=DataType.INT64,
                     is_primary=True)
    schema.add_field(field_name="embedding",
                     datatype=DataType.FLOAT_VECTOR, dim=4)
    schema.add_field(field_name="title",
                     datatype=DataType.VARCHAR, max_length=200)
    schema.add_field(field_name="category",
                     datatype=DataType.VARCHAR, max_length=50)
    schema.add_field(field_name="year", datatype=DataType.INT64)

    index_params = client.prepare_index_params()
    index_params.add_index(field_name="id", index_type="INVERTED")
    index_params.add_index(
        field_name="embedding",
        index_type="FLAT",
        metric_type="COSINE"
    )
    client.create_collection(
        collection_name=COLLECTION_NAME,
        schema=schema,
        index_params=index_params
    )
def insert_data(client):
    data = [
        {"id": 1, "title": "关系数据库导论",
         "category": "数据库", "year": 2022,
         "embedding": [0.92, 0.81, 0.15, 0.10]},
        {"id": 2, "title": "HBase编程实践",
         "category": "数据库", "year": 2023,
         "embedding": [0.89, 0.77, 0.18, 0.11]},
        {"id": 3, "title": "向量检索概论",
         "category": "人工智能", "year": 2024,
         "embedding": [0.12, 0.22, 0.91, 0.88]},
        {"id": 4, "title": "RAG系统设计",
         "category": "人工智能", "year": 2024,
         "embedding": [0.15, 0.18, 0.95, 0.90]},
    ]
    res = client.insert(collection_name=COLLECTION_NAME, data=data)
    print("insert =", res)
def vector_search(client):
    query_vector = [[0.90, 0.78, 0.12, 0.10]]
    res = client.search(
        collection_name=COLLECTION_NAME,
        data=query_vector,
        limit=3,
        output_fields=["title", "category", "year"],
    )
    print("vector_search =", res)
def filter_search(client):
    query_vector = [[0.88, 0.76, 0.14, 0.12]]
    res = client.search(
        collection_name=COLLECTION_NAME,
        data=query_vector,
        filter="category == '数据库'",
        limit=2,
        output_fields=["title", "category", "year"],
    )
    print("filter_search =", res)
def query_data(client):
    res = client.query(
        collection_name=COLLECTION_NAME,
        filter="year >= 2023",
        output_fields=["title", "category", "year"],
    )
    print("query =", res)
def delete_data(client):
    res = client.delete(collection_name=COLLECTION_NAME, ids=[4])
    print("delete =", res)
if __name__ == "__main__":
    client = init_client()
    recreate_collection(client)
    insert_data(client)
    vector_search(client)
    filter_search(client)
    query_data(client)
    delete_data(client)
Milvus CLI的使用方法
Milvus CLI是Milvus提供的命令行管理工具。它基于Milvus Python SDK实现,可以在终端中通过交互式命令完成数据库连接、Collection 管理、索引管理、数据导入、向量检索、标量查询以及用户权限管理等操作。与Python程序相比,CLI更适合教学演示、运维检查和快速验证;与Attu图形界面相比,CLI更便于在服务器、远程终端和脚本化环境中使用。需要注意的是,Milvus CLI本身不是Milvus数据库服务器。使用CLI之前,应先确保Milvus Standalone实例已经启动,并且客户端能够访问服务端地址,启动Milvus Standalone服务的命令如下:
cd /home/hadoop
bash standalone_embed.sh start
1. 安装Milvus CLI
Milvus CLI可以通过pip、Docker镜像或源码方式安装。对于课程实验,最常用的是pip安装方式。8.6.1节中已经安装了Milvus Standalone模式,版本号是3.0.2,相应地,推荐使用PyMilvus 3.0.2与Milvus CLI最新版,具体安装命令如下:
pip install milvus_cli2. 启动并连接Milvus
安装完成后,在终端执行如下命令即可启动CLI:
milvus_cli -h localhost -p 19530 # 连接Milvus Standalone(要确保服务已经启动)进入交互模式后,命令提示符通常显示为(如下图所示):
milvus_cli >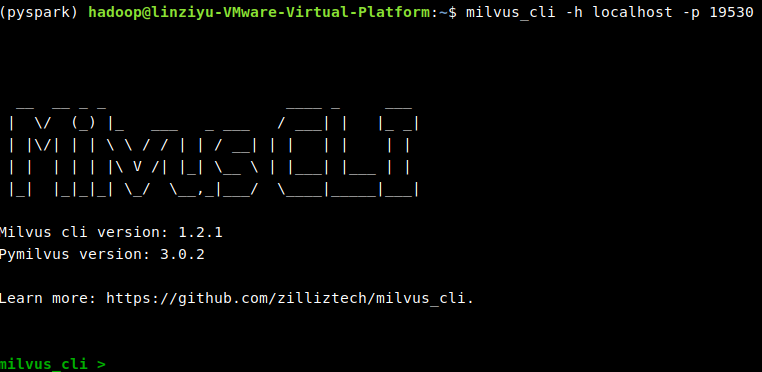
接着可以使用connect命令连接Milvus服务端。若Milvus Standalone运行在本机默认端口,可以执行如下命令(命令运行结果如下图所示):
milvus_cli > connect -uri http://127.0.0.1:19530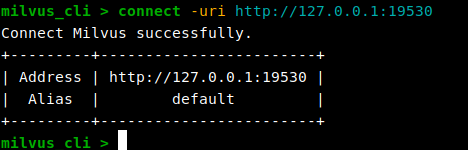
连接成功后,可以列出当前连接、数据库或Collection:
milvus_cli > list connections
milvus_cli > list databases
milvus_cli > list collections
如果需要断开连接,可以使用如下命令:
milvus_cli > disconnect查看Milvus服务版本,可以使用如下命令:
milvus_cli > version退出Milvus CLI,可以使用如下命令:
milvus_cli > exit3. 数据库与 Collection 管理命令
Milvus支持数据库(Database)概念。数据库可以理解为 Collection 的上层命名空间,用于隔离不同应用或不同实验的数据。
例如,可以先创建并切换到一个专用数据库:
milvus_cli -h localhost -p 19530  # 启动Milvus客户端
milvus_cli > connect -uri http://127.0.0.1:19530  # 连接Milvus服务器
milvus_cli > create database -db course_db  # 创建数据库
milvus_cli > use database -db course_db  # 切换数据库
Collection是Milvus中保存实体数据和向量字段的核心逻辑单位。CLI支持交互式创建 Collection,也支持使用JSON Schema文件创建Collection。对于初学者,交互式方式更直观:
milvus_cli > create collection
Please input collection name: course_materials
Please input auto id [False]: False
Please input description []: course material vector collection
Is support dynamic field [False]: False
Please input consistency level(Strong(0),Bounded(1), Session(2), and Eventually(3)) [1]: 1
Please input shards number [1]: 1
Do you want to add embedding function? [y/N]: N

Field name: id
Field type (INT64, VARCHAR, FLOAT_VECTOR, etc.): INT64
Field description []: primary key
Is id the primary key? [y/N]: y
Ensure you have already created vector and primary fields. Do you want to add more fields? [Y/n]: Y

Field name: embedding
Field type (INT64, VARCHAR, FLOAT_VECTOR, etc.): FLOAT_VECTOR
Field description []: vector field
Dimension: 4
Ensure you have already created vector and primary fields. Do you want to add more fields? [Y/n]: Y

Field name: title
Field type (INT64, VARCHAR, FLOAT_VECTOR, etc.): VARCHAR
Field description []: title
Max length: 200
Nullable [False]: False
Default value (type: VARCHAR): [Not set]:
Enable analyzer? [False]:
Enable match? [False]:
Analyzer built-in type (standard, english, chinese, ) []:
Ensure you have already created vector and primary fields. Do you want to add more fields? [Y/n]:

Field name: category
Field type (INT64, VARCHAR, FLOAT_VECTOR, etc.): VARCHAR
Field description []: category
Max length: 50
Nullable [False]:
Default value (type: VARCHAR): [Not set]:
Enable analyzer? [False]:
Enable match? [False]:
Analyzer built-in type (standard, english, chinese, ) []:
Ensure you have already created vector and primary fields. Do you want to add more fields? [Y/n]: Y

Field name: year
Field type (INT64, VARCHAR, FLOAT_VECTOR, etc.): INT64
Field description []: year
Nullable [False]:
Default value (type: INT64): [Not set]:
Ensure you have already created vector and primary fields. Do you want to add more fields? [Y/n]: n
创建完成后,可以查看Collection列表和结构:
milvus_cli > list collections
milvus_cli > show collection -c course_materials
milvus_cli > show collection_stats -c course_materials
如果需要删除Collection,可以执行:
milvus_cli > delete collection -c course_materials删除Collection是不可恢复操作,CLI要求用户确认。
- 索引、加载与释放
Collection创建后,还需要为向量字段创建索引,并在检索前加载Collection。CLI的create index 命令采用交互式方式设置索引字段、索引类型、度量方式和索引参数。例如,为 course_materials 的embedding字段创建IVF_FLAT索引:milvus_cli > create index Collection name (course_materials): course_materials The name of the field to create an index for (embedding): embedding Index name: embedding_idx Index type (FLAT, IVF_FLAT, IVF_SQ8, IVF_PQ, HNSW, AUTOINDEX, DISKANN, GPU_IVF_FLAT, GPU_IVF_PQ, SPARSE_INVERTED_INDEX, SCANN, STL_SORT, Trie, INVERTED): IVF_FLAT Vector Index metric type (L2, IP, HAMMING, TANIMOTO, COSINE): COSINE Index params nlist: 8 <IndexClient.IndexResult object at 0x76577c1b1bd0> Create index successfully!创建索引后,可以查看索引列表、索引详情和索引构建进度:
milvus_cli > list indexes -c course_materials
milvus_cli > show index -c course_materials -in embedding_idx
milvus_cli > show index_progress -c course_materials -in embedding_idx
在服务器版Milvus中,向量检索通常需要先把Collection加载到内存:
milvus_cli > load collection -c course_materials
milvus_cli > show load_state -c course_materials
milvus_cli > show loading_progress -c course_materials
当Collection暂时不再用于检索时,可以释放内存:
milvus_cli > release collection -c course_materialsload和release是理解服务器版Milvus资源管理的重要命令。它们在Milvus Lite本地文件模式中并不明显,但在Standalone和Distributed环境中非常常用。
- 插入、查询、检索与删除数据
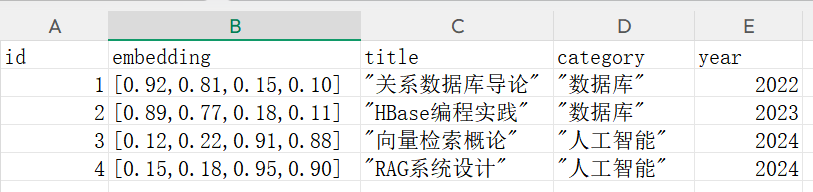
CLI支持逐行插入,也支持从CSV文件导入。逐行插入适合学习和演示:milvus_cli > insert row Collection name: course_materials Partition name [_default]: _default Enter value for id (INT64): 1 Enter value for embedding (FLOAT_VECTOR): [0.92, 0.81, 0.15, 0.10] Enter value for title (VARCHAR): 关系数据库导论 Enter value for category (VARCHAR): 数据库 Enter value for year (INT64): 2022 Inserted successfully.如果数据量较大,可以准备CSV文件并执行:
milvus_cli > insert file -c course_materials "course_materials.csv"course_materials.csv可以从教材官网的“下载专区”的“代码”目录中下载,具体内容如下图所示。
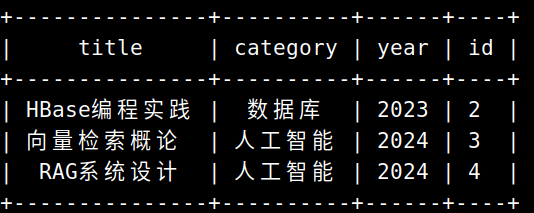
插入数据后,可以用query执行标量条件查询:milvus_cli > query Collection name: course_materials The query expression: year >= 2023 Name of partitions that contain entities(split by "," if multiple) []: A list of fields to return(split by "," if multiple) []: title, category, year timeout []: Guarantee timestamp. This instructs Milvus to see all operations performed before a provided timestamp. [0]: Graceful time. Only used in bounded consistency level. [5]:查询结果如下图所示。
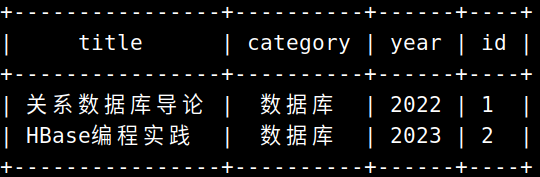
如果要按照主键获取实体,可以使用get:milvus_cli > get Collection name: course_materials IDs (comma-separated): [1, 2] Output fields (comma-separated, or * for all) []: title, category, yearget命令执行结果如下图所示。
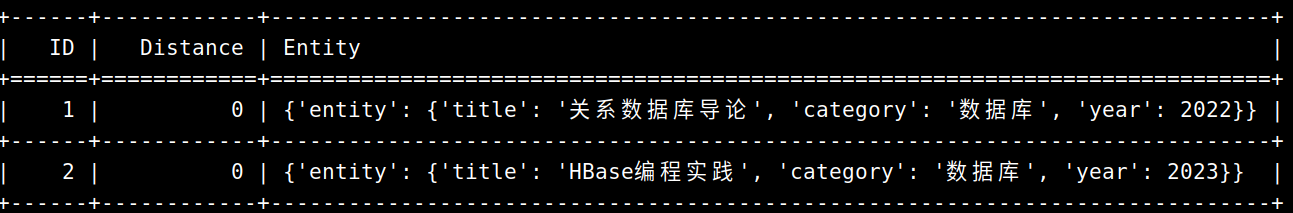
向量相似性检索使用search命令。CLI会提示输入查询向量来源、向量字段、检索参数、Top-K 数量和过滤条件。例如:milvus_cli > search Collection name (course_materials): course_materials The vector field used to search of collection (id, embedding, title, category, year): embedding Vector data (e.g. [0.1, 0.2, 0.3, ...]): [0.90,0.78,0.12,0.10] Metric type: COSINE Search parameter nprobe's value: 4 Groups search by Field []: The specified number of decimal places of returned distance [-1]: The max number of returned record, also known as topk: 2 The boolean expression used to filter attribute []: category == "数据库" The names of partitions to search (split by "," if multiple, press Enter to skip) []: Fields to return(split by "," if multiple) ['id', 'embedding', 'title', 'category', 'year'] []: title, category, year Guarantee timestamp. This instructs Milvus to see all operations performed before a provided timestamp. If no such timestamp is provided, then Milvus will search all operations performed to date. [0]:search命令执行结果如下图所示。
如果需要删除数据,可以按主键删除,也可以按过滤表达式删除:milvus_cli > delete ids -c course_materials The IDs to delete (e.g. [1,2,3]): [4] You are trying to delete 1 entities. This action cannot be undone! Do you want to continue? [y/N]: y {'delete_count': 1}milvus_cli > delete entities -c course_materials The expression to specify entities to be deleted, such as "film_id in [ 0, 1 ]": year < 2023 You are trying to delete the entities of collection. This action cannot be undone! Do you want to continue? [y/N]: y {'delete_count': 1}删除后可再次执行query或get验证结果。